Что проверяли
Работа команды из Школы и госпиталя стоматологии Уханьского университета (первый автор Yuting Wen, последний — Dong Yang) отвечает на практичный вопрос: может ли общий ИИ-чат заменить живого наставника на симуляторе. Студентов учили базовому препарированию зуба — это самая ранняя ручная процедура в стоматологическом образовании.
Сравнивали два способа получить подсказку во время тренировки на одном и том же виртуальном тренажёре. В обеих группах можно было обращаться за помощью без ограничений: контрольная получала ответы от преподавателей на месте, экспериментальная — от ChatGPT-4.0 (OpenAI).
Как устроен эксперимент
- Участники. Набрали 129 студентов четвёртого и пятого курсов пятилетней программы одного ведущего китайского вуза (название в разделе методов не указано). Они знали теорию, но не проходили доклинической практики и не работали на VR-симуляторе. Возраст — от 17 до 23 лет, в среднем 21,86.
- Отсев. Шестерых исключили до рандомизации: они не прошли калибровку айтрекера. В анализ вошли 123 человека — 62 в группе ChatGPT (30 юношей, 32 девушки) и 61 в контрольной (31 и 30).
- Распределение. Сначала студенты прошли письменный тест по теории и разделились на три страты по результату — высокий, средний, низкий. Внутри каждой страты их случайно распределили по группам.
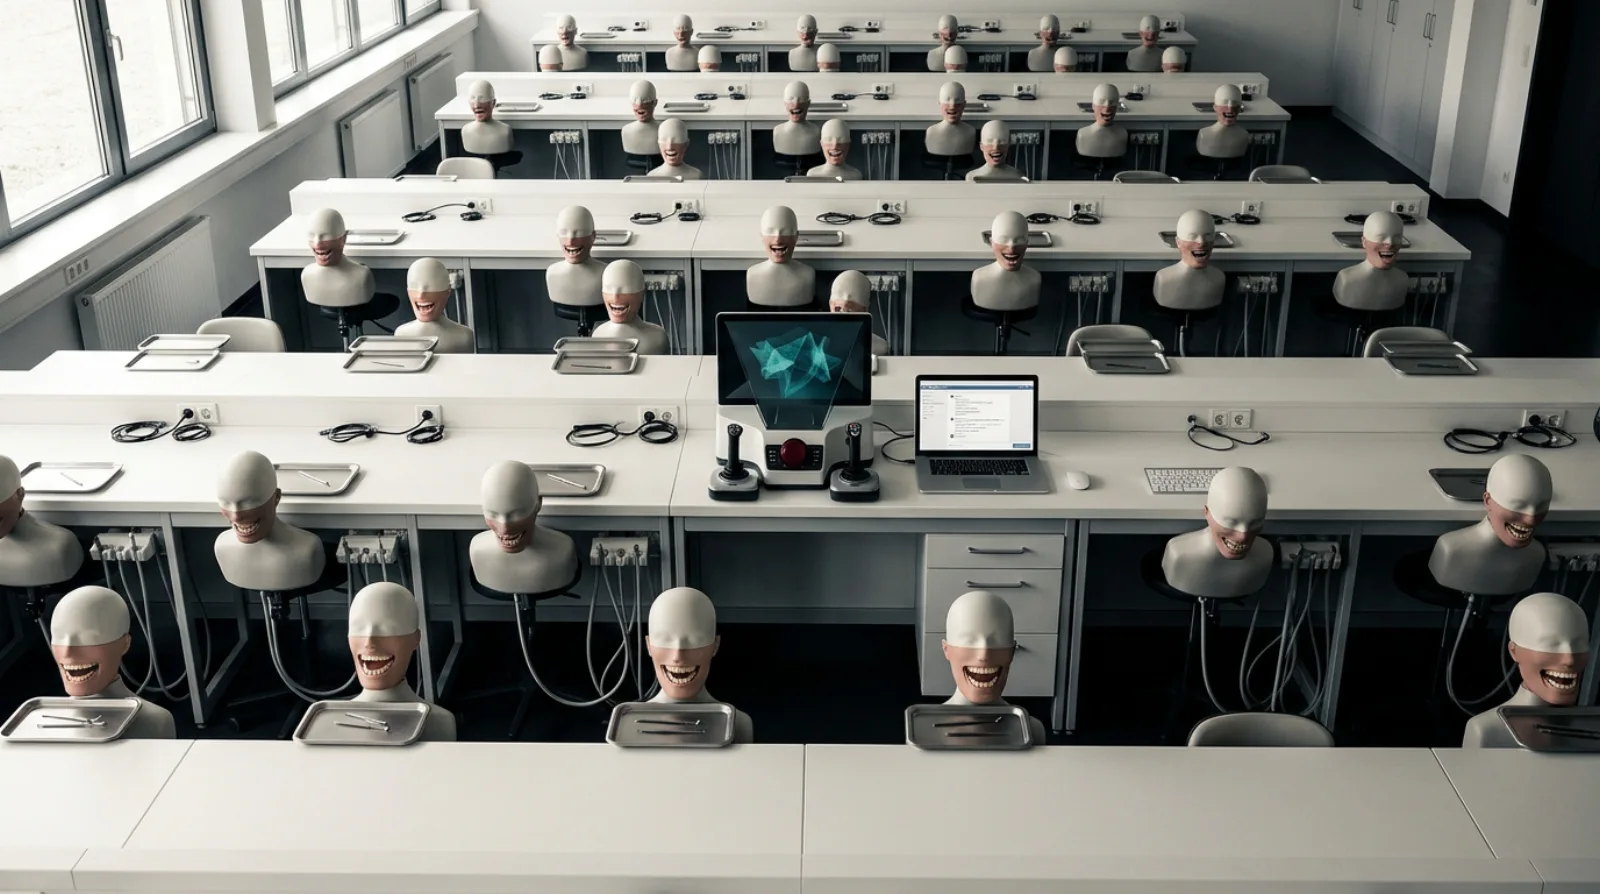
- Тренажёр. Настольная VR-система с объёмным монитором и тактильными джойстиками, которые управляют виртуальными инструментами; обратная связь по усилию — 1000 Гц. Это не шлем.
- ChatGPT. Использовали версию 4.0 с «простой контекстной настройкой», в отдельном браузере на компьютерах, не связанных с тренажёром. Студенты получили стандартные шаблоны запросов и инструкцию. Ассистенты исследователей проверяли ответы ИИ на безопасность и ошибки.
- Срок. Семь дней по одному часу. Шесть дней — обучение, на седьмой — задание с приборами.
- Оценка. Практический тест на 30 минут оценивали два эксперта по критериям, адаптированным из китайского лицензионного экзамена; согласованность экспертов — r = 0,89.
- Слепота. Эксперты и аналитики не знали, кто в какой группе. Студенты и ассистенты на месте знали свою группу — полного ослепления достичь нельзя.
Что получили
Основной показатель — оценка за практический тест от 0 до 100.
| Группа | Среднее (SD) |
|---|---|
| ChatGPT-4.0, без преподавателя | 77,25 (11,86) |
| Преподаватель на месте | 67,39 (16) |
Разница — 9,86 балла (95 % ДИ 4,81–14,91); тест Уэлча t = 3,88, размер эффекта d = 0,70, P < 0,001.
Остальные показатели авторы относят к исследовательским. По ним группа с ChatGPT показала:
- меньший прирост диаметра зрачка — 0,180 мм (SD 0,136) против 0,346 мм (SD 0,150); разница 0,166 мм (95 % ДИ 0,115–0,217). Зрачок здесь — косвенный показатель когнитивной нагрузки;
- более сфокусированный взгляд на операционной зоне по данным айтрекера;
- более сильную активность в префронтальной, моторной, зрительной ассоциативной коре и в височно-теменном стыке по ближней инфракрасной спектроскопии (fNIRS);
- более высокие баллы пространственных тестов: P = 0,003, 0,004 и 0,004 для низкого, среднего и высокого уровня;
- у студентов с низким исходным баллом — выше самоконтроль обучения (P = 0,02);
- больше удовольствия от занятий (d = 0,98) и меньше злости (d = 1,05); по фрустрации различие не достигло значимости (P = 0,07); больше вовлечённости.
Авторы подчёркивают про fNIRS: большая активность может отражать усилие, внимание, новизну задачи, сложность или другие неизмеренные факторы, и исследование «не может определить, означают ли эти различия лучшее обучение».
Что нужно учитывать
Это не исследование на пациентах. Оно показывает, как студенты выполняют базовое препарирование на практическом тесте сразу после недели тренировки на симуляторе (где именно проходил тест, в статье прямо не сказано). Из текста статьи и ограничений:
- обучали только базовому препарированию, перенос на сложные манипуляции не проверяли;
- наблюдали одну неделю; удержание навыка и результаты в клинике не измеряли;
- эмоции оценивали одним вопросом на показатель, а не стандартизированными опросниками;
- множественные сравнения (много показателей) — несмотря на поправку Холма — Бонферрони, остаточное завышение значимости, по словам авторов, исключить нельзя;
- как именно студенты использовали ChatGPT, не фиксировали;
- авторы не исключают, что студенты могли переложить решения на ИИ и привыкнуть полагаться на его подсказки;
- проверить каждый ответ ИИ ассистентам в испытании было невозможно.
Расчёта размера выборки в тексте статьи мы не нашли. Регистрация испытания — Китайский реестр клинических испытаний ChiCTR2500110063, комитет по этике — Уханьского университета, финансирование — гранты Уханьского университета, его стоматологической школы и Естественнонаучного фонда провинции Хубэй; конфликта интересов авторы не заявили.
Ещё одна деталь: сравнивали ChatGPT с преподавателем, а не с отсутствием помощи. Сколько времени и внимания преподаватели смогли уделить каждому студенту, в тексте не описано.
Что это значит для обучения стоматологов
Главный вывод авторов осторожный: результаты дают «предварительные соображения» о том, как можно встроить генеративный ИИ в доклиническое обучение. Для вузов это повод проверять такие схемы в собственных условиях и добавлять надзор за ответами ИИ, а не заменять им преподавателя.
Для студентов практический вывод скромнее. Пока работа показывает, что за неделю на симуляторе при доступной подсказке в чате базовый навык формируется не хуже, а по баллам теста лучше, чем при подсказке от преподавателя. Как устроена практика на реальных пациентах, мы разбирали в материале о клинической практике студента-стоматолога; путь после вуза — в путеводителе по обучению стоматолога.
Частые вопросы
Это исследование на пациентах?
Нет. Студенты тренировались на виртуальном симуляторе, а авторы прямо пишут, что реальные клинические результаты не измеряли.
С чем сравнивали ChatGPT?
С преподавателями, которые давали ответы на месте. Отдельной группы без помощи не было.
Насколько надёжны результаты?
Основной результат — разница в баллах практического теста — статистически значима. Остальные показатели авторы называют исследовательскими, а выводы — предварительными.
Почему нельзя сказать, что ИИ учит лучше?
Срок — неделя, навык — один базовый, измеряли результат сразу после обучения, а удержание навыка и клиническую практику не проверяли.
Где опубликовано исследование?
В Journal of Medical Internet Research, 2026, том 28, статья e90938. Ранняя версия — препринт от 6 апреля 2026 года.